孩子有阅读材料要做精读,我手上有大量零散的英文——课本里的几页、新闻里的一段、老师发的打印稿。能做讲解,但每次都要从头讲一遍:生词得自己挑、音标得自己查、语法点得判断该讲哪个。重复劳动最多的那部分,恰恰是最该固化成工具的部分。
于是有了这么一个东西:给一段英文,产出一份学生能自己读懂的中文精读讲义。左边是课本原页(书上的高亮天然保留),右边是对应段落的中文译文(默认收起),下面是生词表、逐句的句法拆解、语法重点和练习。整份是一个 HTML 文件,断网能开、能打印、每个生词和句子点一下能听到读音。
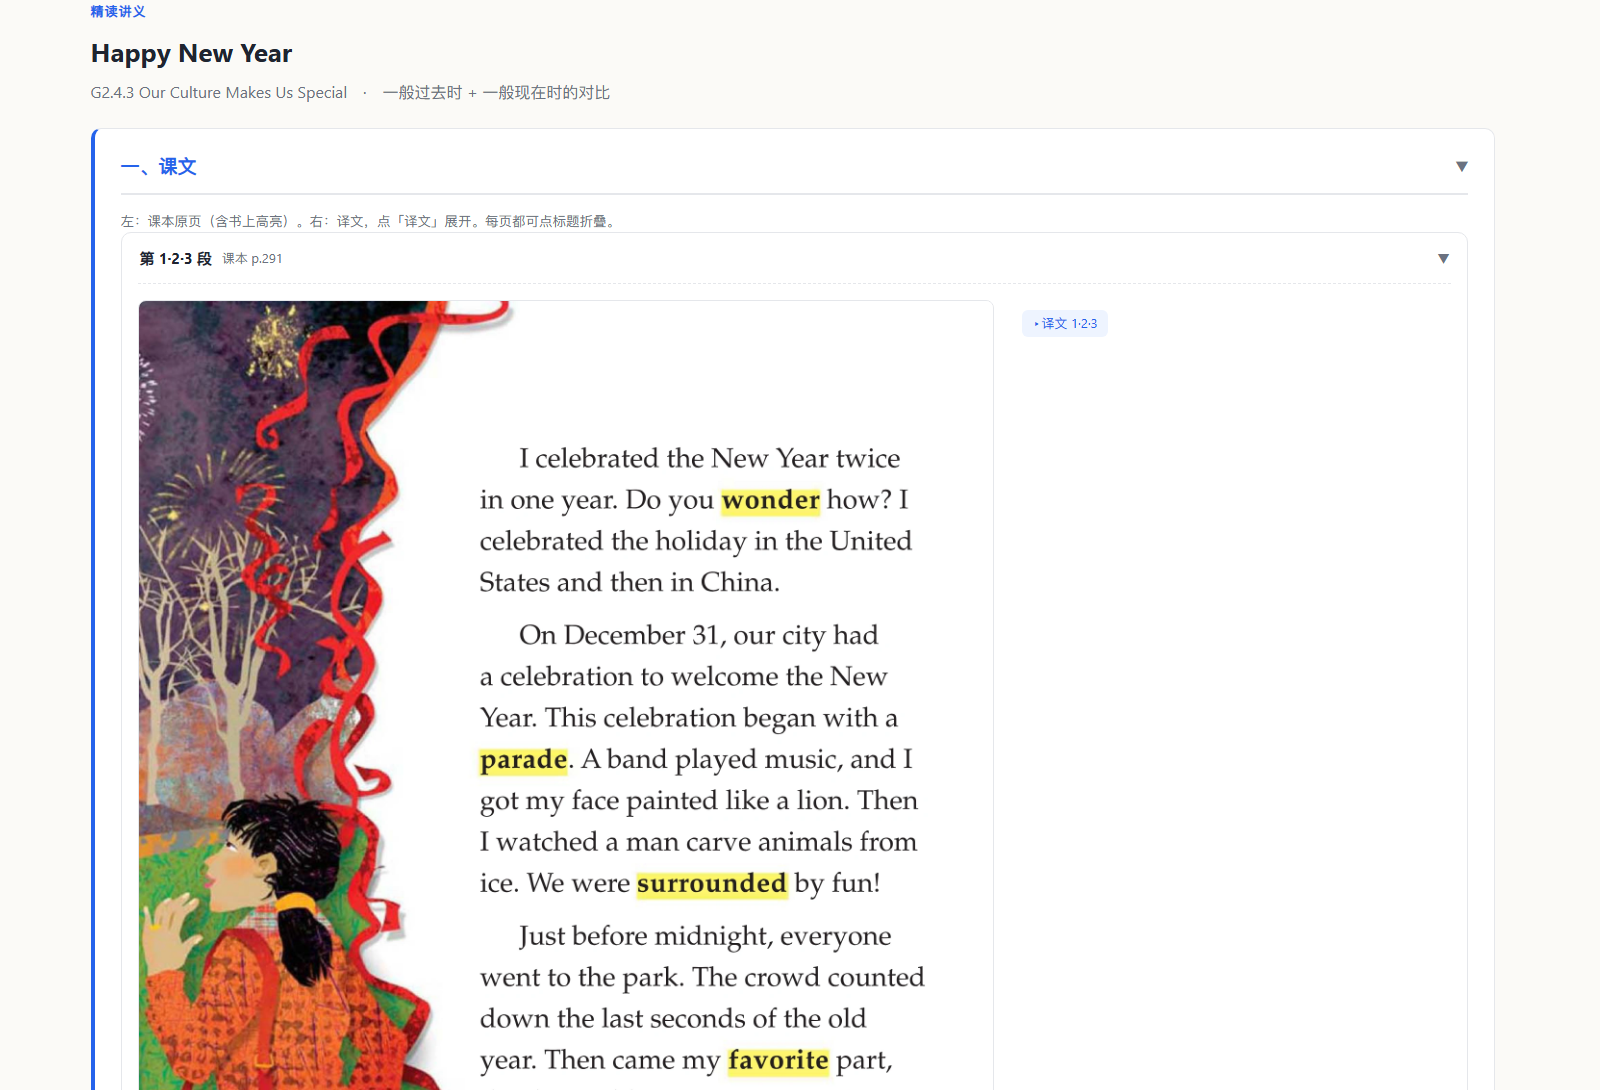
定稿后的第一节:左边是课本原页(书印的高亮保留),右边是对应段落的中文译文,默认收起;每页可单独折叠。
这篇文章记的是它被做出来的过程。重点不在最终长什么样,而在于中间改了多少次、每次为什么改。 18 轮对话里有 12 轮的产出是「这里不对,改成那样」,这些反馈本身就是最有价值的部分。
一、动手之前,先找有没有现成的
第一反应不是写,是问:这东西别人做过吗?搜了一圈,结论是有接近的,但没有能直接用的。
| 找到的 | 做了什么 | 差在哪 |
|---|---|---|
| Literature Lesson Builder | 文 → 完整课程包:教案、PPT、三档练习、互动游戏 | 面向文学作品与英文授课,不做中文释义层,也没有逐句句法 |
| reading-analysis | 中文、126 张方法卡,解析应试阅读 | 目标是做题,不是读懂课文 |
| gaokao-english-tutor | 对话式陪学,苏格拉底提问 | 是「陪学生练」不是「产成品」 |
这一圈搜索的价值不在抄,而在确认哪些东西已经有共识:精读课普遍走「读前—读中—读后」三段;词汇教学有 ECDW(引出→概念核对→操练→书写)这套;AI 生成讲义最常出的三个毛病是「生词选得太学术」「理解题太字面」「语法点选的词在文里只出现一次」。
最后一条直接变成了后面的硬规则:语法点必须在文中出现 3 次以上,不够就换一个。
同时翻到一份外研社转载的教师专题,讲小学英语怎么教语法,里面人教社那位老师的 24 个字救了我后面很多次返工:「意义领先、先例后法、提醒注意、点到为止、随遇随点、适时归纳」。反面案例也很具体——有老师把「各种动词形态变化未经选择和简化就讲给学生」,结果学生不但记不住,还对英语产生畏难。
所以 skill 从第一天就定了一条:一节课最多 3 个语法点,讲不成语法书。
二、第一版:什么都不设限
第一版只给了一篇文章,让它出讲义。产出的东西看着挺全:梗概、生词、逐句、语法、练习、原文。
问题在第二轮就暴露了。孩子读完说了一句话:「练习题答案在旁边,我一眼就看到了。」
这一句把整件事的方向定了:这是给学生自己读的东西,不是给我看的资料。答案必须藏起来。
接着是更难的判断——「讲多深」。第一版逐句精讲写的是词义(pay attention 是固定搭配,意思是注意),这跟生词表重复了。改成讲句子结构之后,才有了真正的信息:哪部分是主语、哪部分是状语、为什么这里不是定语。
三、版式:改了五轮才定下来
这部分是最耗时的,也是最有意思的——因为每一轮的要求都很具体,而具体的要求之间经常互相矛盾。
| 轮次 | 要求 | 实际改动 |
|---|---|---|
| 1 | 太窄了 | 正文 max-width 860 → 1500px |
| 2 | 生词表挤在一起 | 加 table-layout:fixed + <colgroup> 定列宽 |
| 3 | ①②③ 换成 一、二、三 | 编号改中文数字,每节都能折叠 |
| 4 | 句子字体大一点 | 逐句精讲的原文 16 → 19px |
| 5 | 第一部分换成图片 | 删掉文字重排,左图右文 |
第 3 轮顺带删掉了一批「提示性文案」:阅读提示、先看句子的骨架:谁在做(主语)…、答案在每题下面,自己做完再点开、这份讲义自己读完就能懂,不需要先看视频。
这些字是我第一版觉得「贴心」才加的。删掉之后版面上反而清爽——因为版面本身就在说这些事,节标题写着「练习」,答案在里面折着,不需要再解释一遍。
3.1 两栏的最后定稿
第一版的两栏是英文和中文各占一半,后来全推翻:
- 一开始:逐句对照,左边一句英文右边一句中文 —— 被否,要求一段英文配一段中文
- 然后:整段文字排下来 —— 被否,要求直接把课文图片放上去,保留书上的高亮
- 最后:左图右文,但图片其实可以再大点 → 列宽从 1:1 改成 2:1
定稿的 CSS 很小:
.split{display:grid;grid-template-columns:minmax(0,2fr) minmax(280px,1fr);gap:28px}
.zhcol{position:sticky;top:16px}
@media (max-width:900px){.split{grid-template-columns:1fr}}
译文占 1/3、图占 2/3,右侧 sticky 跟着滚动。手机上自动堆成一列。
再加上「每一页都能独立折叠」——一张图加它的译文包进一个 .pagebox,标题写「第 1·2·3 段 · 课本 p.291」。三页收起后只剩三行,扫一眼就知道这份材料有几页、每页管哪几段。
四、朗读:三次调整
第一次是想用站点里已有的 325 个真人录音。查了一下覆盖率,不到三成——新闻类文章一半的词没有。放弃。
第二次改成浏览器自带的 speechSynthesis,纯前端、断网可用。选语音时有个坑:Chrome 在 Windows 上会同时列出「系统离线语音」和「Google 网络语音」,后者断网时是静默失败——点了既不出声也不报错。所以挑语音必须先筛 localService === true。
第三次是补全:一开始只有生词能读,后来要求「逐句精讲里的句子也能读」。于是每个句子后面加了一个按钮,data-say 存整句英文,把意群符号 | 去掉。
还有个纯视觉的坑:按钮本来用 🔊 emoji,导出 PDF 时这个字符不渲染,还会把按钮撑成两行。换成内联 SVG 才稳。
五、生词判定:从 91 个收到 24 个
这是整个过程中最像「工程」的一段。
第一版写了张「小学已学词表」做减集,跑出来一篇 176 词的文章有 91 个生词候选——超过半数,等于没筛。
原因是只做了一次减法:不在小学词表里的都算生词。于是 interesting、huge、ocean、everyone、through 全进来了。
第二次加了第二张表:高频词。判定规则变成「两张表都不命中才算生词」。为了把屈折形式也盖住,词表里直接收了 painted / watched / came / brings / includes / leaped / lit / hung 这些变形。
效果:
| 版本 | 生词候选 | 说明 |
|---|---|---|
| 只有小学词表 | 91 | 超过半数,等于没筛 |
| 加高频词表 | 57 | 排除了 34 个 |
| 补屈折形式 + 专有名词按词组收 | 24 | 剩的都是真该记的 |
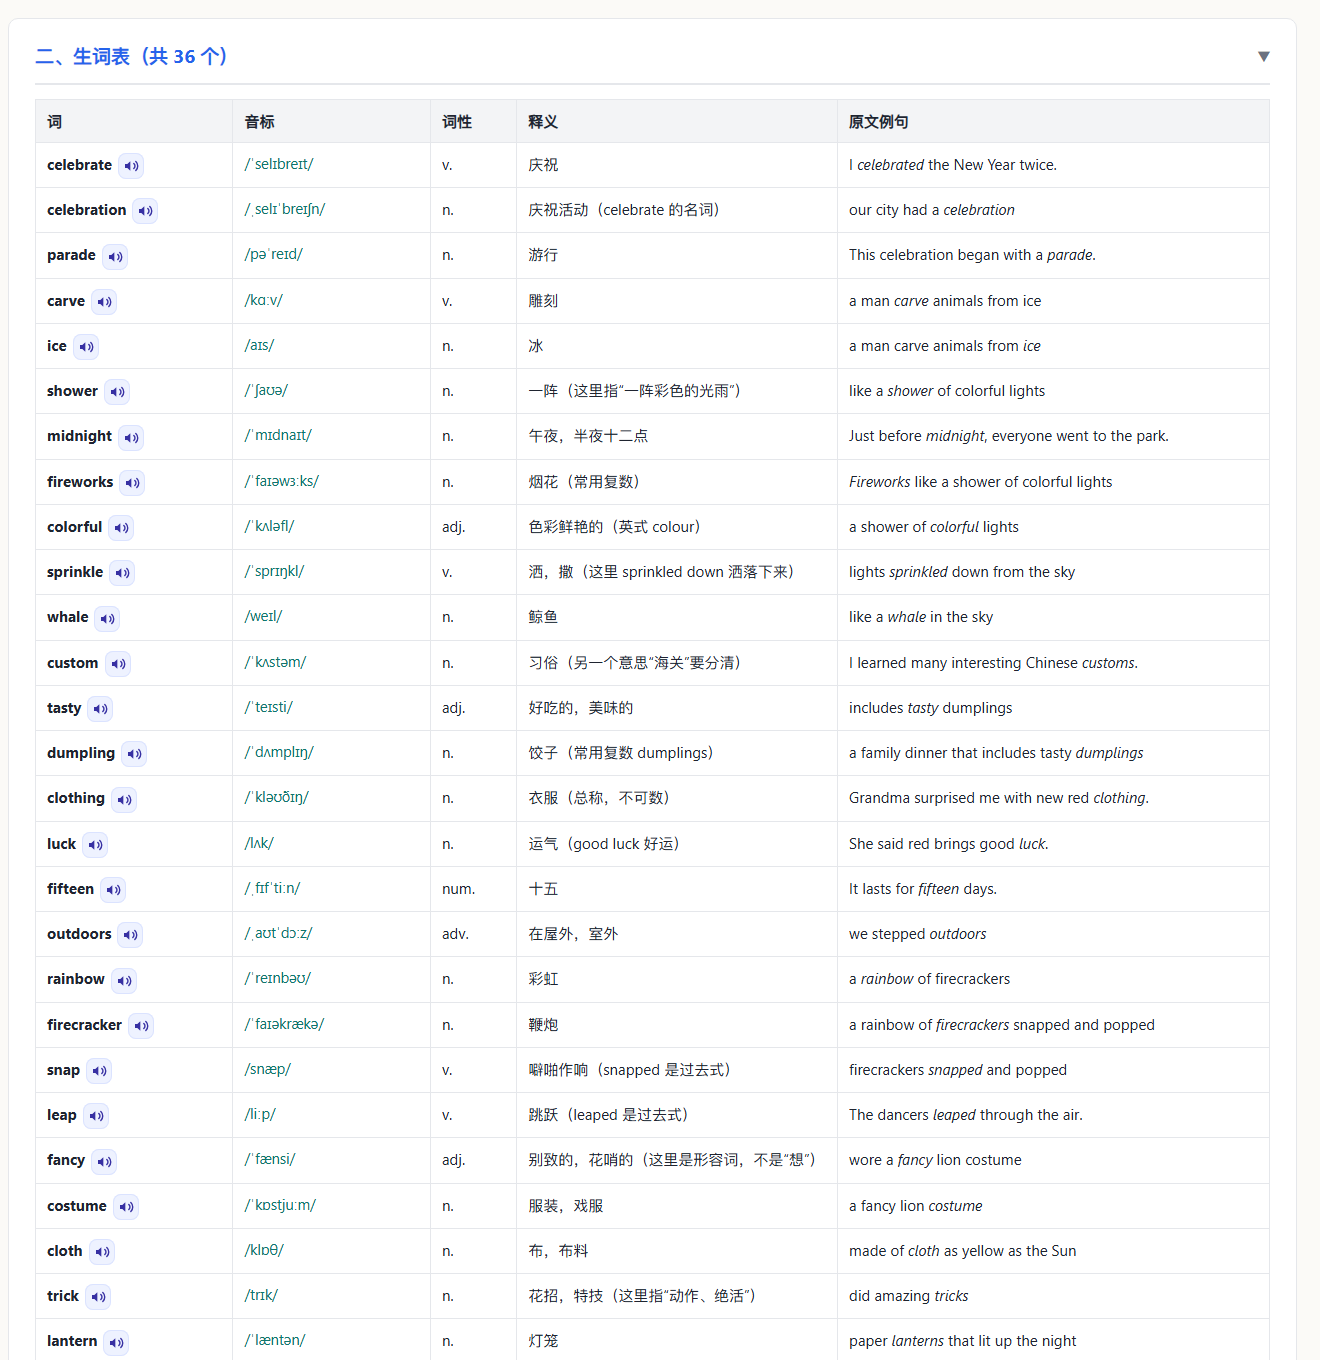
生词表:词、音标、词性、释义、原文例句五列,每个词后面一个小喇叭。这一篇最终是 36 条,其中 30 个词 + 6 个词组。
最终保留的 24 个是:celebrate / celebration / parade / carve / ice / shower / midnight / fireworks / colorful / sprinkle / whale / custom / tasty / dumpling / clothing / luck / fifteen / outdoors / rainbow / firecracker / snap / leap / fancy / costume / cloth / trick / lantern / festival / hang / balloon,外加 6 个词组。
三条配套细则也跟着定下来:
- 专有名词按词组整体收:
United States、Lantern Festival、New Year's Eve、lion dance各算一条,不拆成单词再单列 - 缩写不单列:
I'd、it's、year's、grandma's全部排除 - 脚本必须把「已排除的高频词」打印出来,让人能复核有没有误伤
最后这条很重要。词表是死的,文章是活的——如果哪篇里 custom 是核心词,却因为进了高频表被排除,那就是工具的错。所以排除清单必须可见。
六、句法:给每个中文术语加英文
到后期,孩子开始问「什么是宾补」。中文术语对一个六年级学生是空的,必须给英语。于是每处中文术语后面都跟上英文:
结构:主语(subject)| 谓语(predicate)celebrated | 宾语(object)the New Year | 状语(adverbial)twice in one year
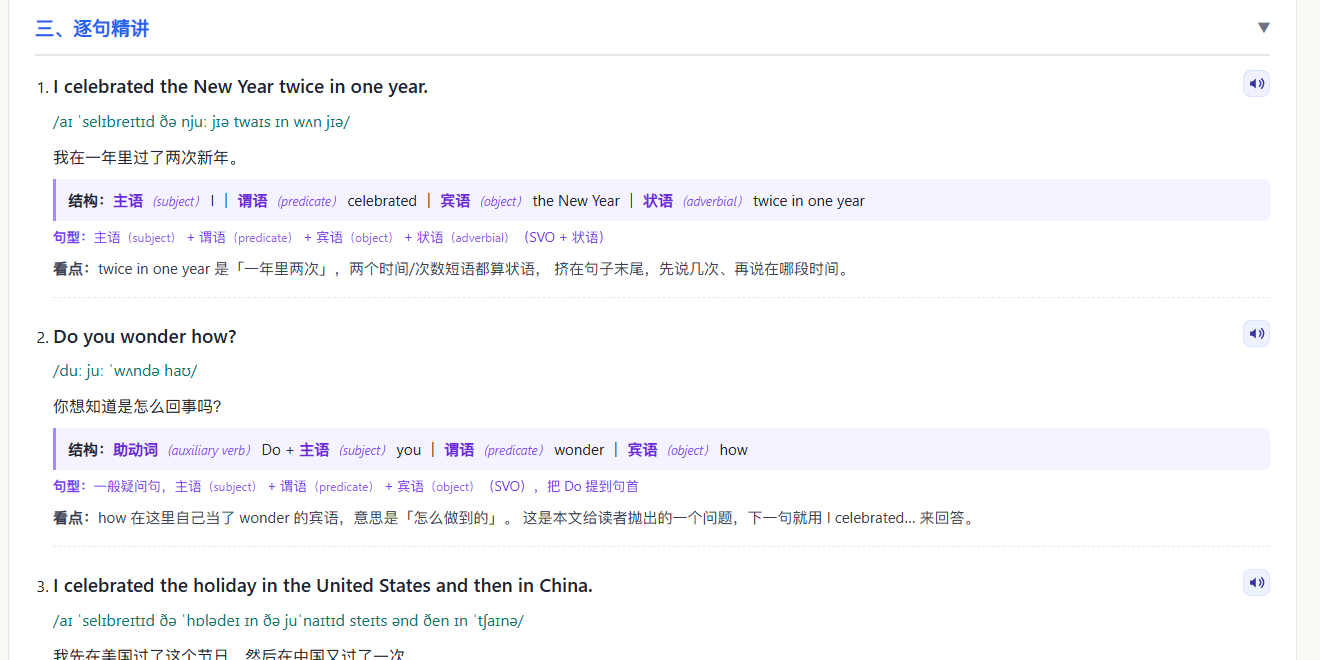
逐句精讲:原文、音标、译文、「结构」行(每个成分落到具体的词上)、「句型」行,最后一行是这一句的看点。
一共标注了 111 处,涉及 16 个术语。SV / SVO / SVP / SVOC 这几个骨架缩写保持不变——学生认的就是这几个字母,加上英文全称反而更乱。
这里也踩了一个纯粹的 CSS 坑:给英文注释用的类名叫 .en,跟模板里「英文句子段落」的 .en{display:flex} 撞了,结果「主语」下面单独换行显示「( subject )」。改成 .gl 才正常。
七、图:内嵌还是外置
中途有一版把三张课本页图 base64 内嵌进 HTML,理由很正当——「单文件更好发给别人,离线双击也能开」。
实测下来 HTML 3.9 MB。放进站点的 iframe 里,加载明显变慢,下载也慢。
改成图片放 handouts/img/、HTML 里用相对路径之后:
| 方案 | HTML | 图片 | 加载 |
|---|---|---|---|
| base64 内嵌 | 3.9 MB | — | 每次打开都要下 3.9 MB |
| 外置相对路径 | 93 KB | 1.5 MB(可缓存) | 首屏只下 HTML |
图片本身也做过一次取舍:一开始为了控制体积压到 1400px、质量 82;后来要求「尽量保留高清」,改回原始分辨率 1776×2346 + webp quality 95。实测与原 PNG 的差异:99.9% 的像素色阶差小于 8,肉眼无差,体积只有 PNG 的约 20%。
八、把规则沉淀下来
改到第 12 轮左右,开始出现一个现象:改好的东西,下篇文章又丢了。因为每次都是「在对话里说完就算」。
于是进入沉淀阶段。最终的结构是:
english-article-notes/
  SKILL.md                        ← 工作流:输入 → 生词 → 语法 → 写 → 自检
  scripts/find_missing.py         ← 生词判定 + 音标查表
  references/
    grade5-known.json             ← 两张内部标尺:小学已学词 + 高频词
    handout-format.md             ← HTML 骨架 + CSS + 朗读脚本 + 检查清单
    grammar-rules.md              ← 语法讲解六条规矩
    sentence-notes.md             ← 逐句精讲写法 + 中英术语对照表
    example-lesson1.md            ← 唯一范文(校准详略)
    site-writeback.md             ← 可选:写回站点
几个设计上的选择值得记一笔:
范文只放一个。 第一版放了两个,模型会摇摆。一个具体的例子比十条抽象要求管用。
规则写成「可执行的东西」。 「生词全录」不是一句话,而是两张 JSON 词表加一个脚本;「术语要加英文」不是一句话,而是一张 28 行的对照表。
参照文件按需读,不进主文件。 SKILL.md 只写流程和判断,细节全部拆到 references/。触发时才读,平时不占上下文。
踩过的坑要写进文件头。 比如 handout-format.md 里专门有一段:
⚠ 类名必须是
gl,不能叫en——.en在模板里是「英文句子段落」的类名,复用会把英文注释撑成单独一行。
这种备注对后来的人(包括三个月后的自己)比任何规范文档都有用。
九、发布到站点
站点本来已经有「讲义」模块:左侧列出 handouts/ 这一层的 HTML,右侧 iframe 打开。只要把文件放进去就能看到。
放进去之后发现一个细节:侧栏显示的是文件名。handouts/index.json 里那个 title 字段根本没有被实现,handout.js 一律取 it.name。
所以最后一步定下来的放法是:
handouts/
  G2.4.3 Our Culture Makes Us Special - Happy New Year.html   95 KB
  img/
    happy-new-year-p291.webp   490 KB
    happy-new-year-p292.webp   563 KB
    happy-new-year-p293.webp   442 KB
想要什么样的标题,就把文件命名成什么样。 这条比写配置简单,也更不容易忘。
顺手把 handouts/README.md 里「推荐 base64 内嵌」的说法也改掉了——那是在还不知道体积代价时写下的。
十、一些数字
| 维度 | 数字 | 备注 |
|---|---|---|
| 对话轮次 | 18 | 其中 12 轮是「这里不对,改成那样」 |
| 版式大改 | 5 次 | 单栏 → 逐句对照 → 段落 → 左图右文 → 2:1 |
| 生词候选 | 91 → 24 | 两张标尺 + 屈折形式 |
| 讲义文件 | 95 KB | 外置图片后 |
| 图片 | 3 张,合计 1.5 MB | 原始分辨率,webp q95 |
| 语法点 | 3 个 | 每个在文中出现 ≥3 次 |
| 逐句精讲 | 25 句 | 都有结构行和句型行 |
| 可点读位置 | 36 个 | 23 个单词 + 13 个句子 |
十一、已知限制
| 限制 | 说明 |
|---|---|
| 生词表依赖人工复核 | 高频词表只能覆盖通常情况;某篇文章里若把常用词当核心词用,仍会被漏掉 |
| 语法点需要判断 | 脚本给不出「哪个结构值得讲」,这一步只能靠读 |
| 音标 | 站内词表只覆盖 325 词,其余由模型补标,个别多音词可能不准 |
| 语音 | 依赖系统语音,音色因机器而异;只保证能听清,不保证好听 |
| 图片版课文不可复制 | 换成图片后,正文不再是可选中的文本 |
最后一条是明确的取舍:课本原页能让学生对着书一一对上,但代价是失去了文字的可检索与可复制。如果哪天更看重后者,得把这部分换回来。
十二、复盘
回头看,这个 skill 里真正难写的部分,没有一处是代码。
- 难在把模糊的要求变成可执行的规则:「生词全录」四个字,落成 1000 多个词的词表加一个脚本才算数
- 难在接受推翻:版式改了五轮,前四轮的工作全部作废。但正因为反复改,最终的版本才知道每个细节为什么长那样
- 难在写下反面案例:
.en撞名、🔊不渲染、base64 撑到 4 MB——这些写进文件头,比写「请使用正确的类名」有用一百倍
至于 AI 在这里扮演的角色,还是那句话:人定方向和验收,AI 负责查证、写代码、改错。
18 轮里有十几轮,我说的话不超过二十个字:「太窄了」「换成图片」「加英文」「不要 base64」。真正的工作量在对面——把「太窄了」翻译成 max-width: 1500px,把「用图片」翻译成一套两栏网格加折叠结构,然后自己截图看一眼对不对。
这大概就是现在这个阶段的真实分工。