孩子的英语资料,曾经散在四个地方:课本 PDF 在一个文件夹,课文音频在另一个,动画视频在第三个,课课练录音和答案在第四个。Wonders 和 Peppa Pig 又是另外两套目录。资料并不缺,缺的是一条把“读—练—复习—看见进步”串起来的路。
于是有了这个网站:一个只在本机运行的纯静态站点。双击一个 bat,浏览器打开 http://localhost:8000;麦克风、视频拖动、SQLite 落库都正常。没有账号,没有云同步,没有前端框架,也没有打包器。
代码注释能追到 9 月底;到 10 月 18 日,仓库里留下了 24 次提交。这篇文章分两部分:先按页面讲它有哪些功能、每个页面怎么用;再单独讲实现上的关键决定,以及 AI 编程在其中的作用。功能是主角,技术是幕后。
一、一页看全
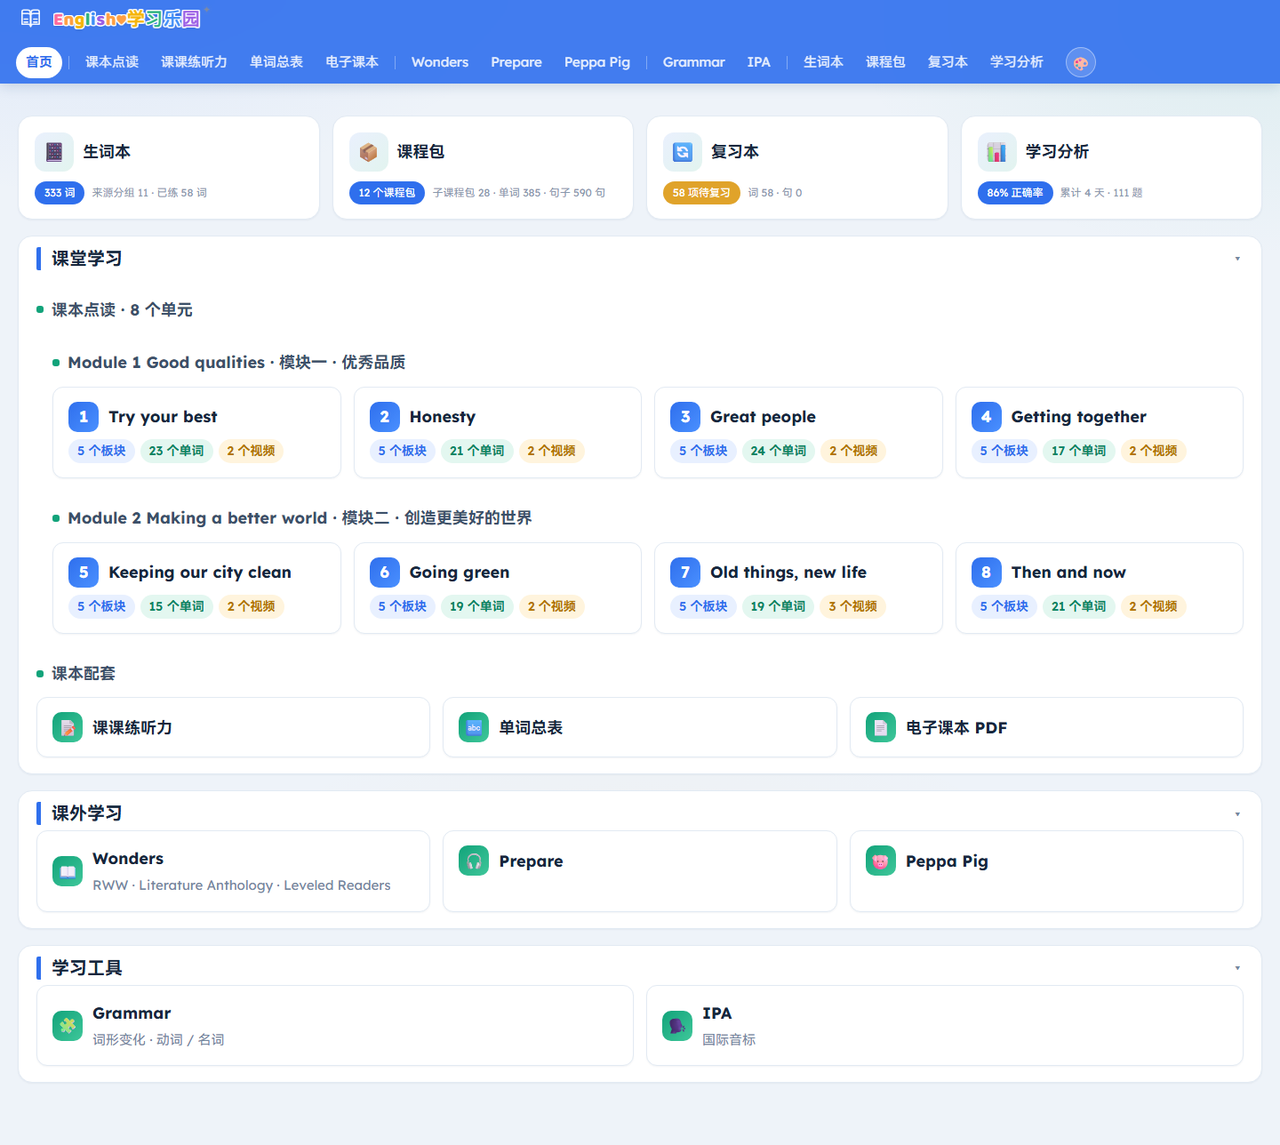
首页:四张统计卡 + 课堂学习 / 课外学习 / 学习工具三块,点卡片直接进入对应模块。
导航栏一共 14 个入口,按用途可以分成四块:
| 板块 | 模块 | 一句话说明 |
|---|---|---|
| 课堂学习 | 课本点读、课课练听力、单词总表、电子课本 | 把纸面课本变成可点、可听、可跟读的页面 |
| 课外学习 | Wonders、Prepare、Peppa Pig | 三套原版资源的阅读与听力 |
| 学习工具 | Grammar、IPA | 词形变化与国际音标 |
| 学习闭环 | 生词本、课程包、练习、复习本、学习分析 | 从“见过的词”到“记住的词” |
首页不是一张“功能介绍页”,而是一块学习仪表盘:生词本有多少词、课程包有多少句、今天有多少项待复习、最近正确率如何,点进去就是对应的模块。另有 5 套视觉主题、A4 四线三格打印练习,以及一个按“课堂 / 课外”两条线各自选择的年级下拉框。
它从一开始就不是“把课文搬上网页”的展示页。真正的重心在后半段:生词本 → 课程包 → 练习 → 复习 → 分析。前半段解决“看得见、听得到”,后半段解决“练得着、记得住”。
一条典型路径是:在课本点读里遇到生词 → 加进生词本 → 勾选生成课程包 → 在练习台练几轮 → 复习本按间隔推荐 → 学习分析看正确率。下面按页面拆。
二、功能介绍
1. 课堂学习:课本点读、课课练、单词总表、电子课本
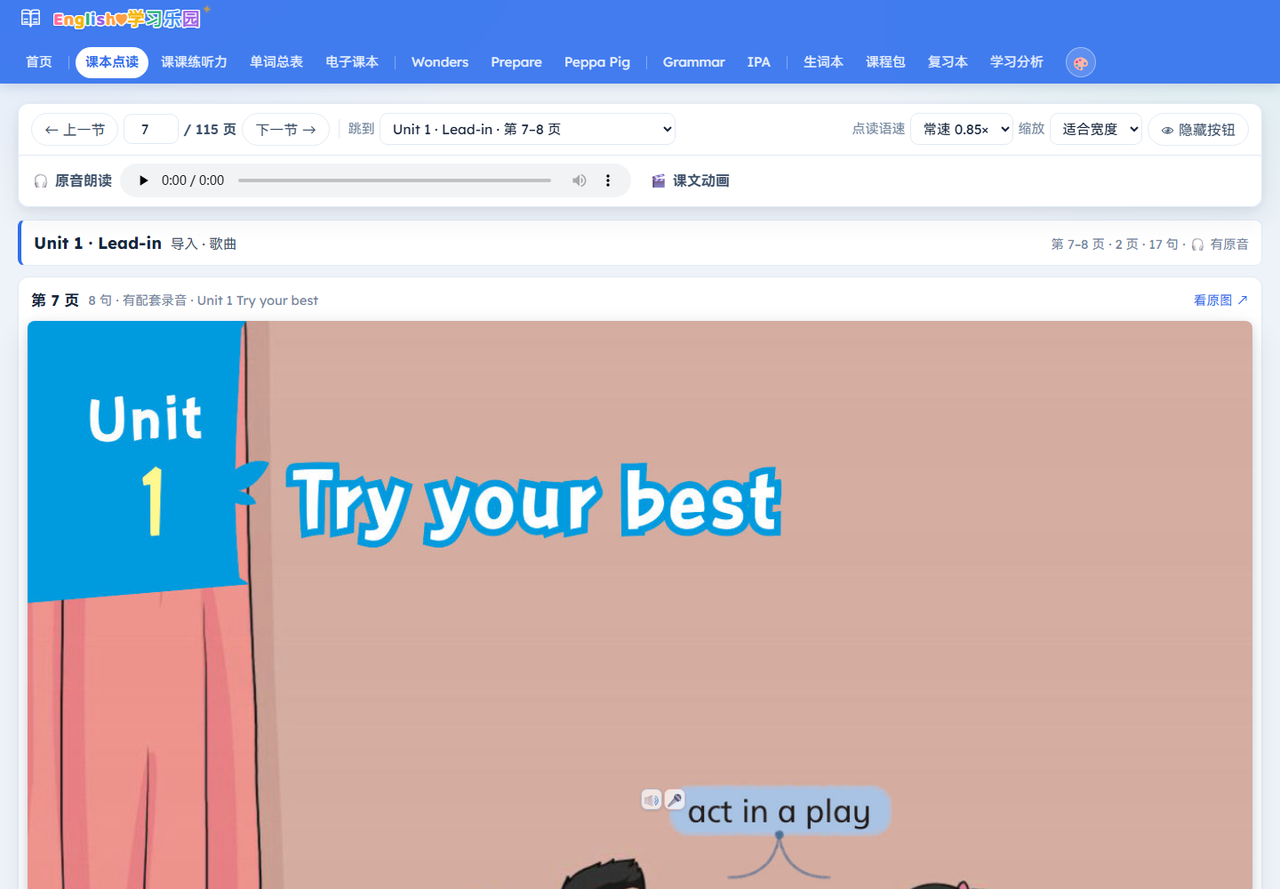
课本点读:页面保持教材原版式,句子旁浮出 🔊 点读 / 🎤 跟读控制条。
课本点读覆盖译林版六年级上册的 8 个单元、40 个板块、159 个单词、285 个句子、17 段课文动画,配一本 115 页的电子课本。
它的阅读单位不是“页”,而是“节”——一个音频板块。Lead-in、Cartoon time、Sounds in focus、Story time 这些板块往往横跨 2 到 5 个印刷页,所以页面按节顺着排下来,顶部固定一条媒体栏:原音朗读和课文动画。
页面本身来自课本 PDF 的原始页面图片,不做文字重排。图文混排、分栏、标注、颜色都是教材的一部分,重排一定失真。每一句旁边浮出 🔊 点读 / 🎤 跟读按钮:点读播放原音,跟读录音后给出评分;评分结果在右下角浮层里出现,不打断阅读位置。点读语速可以调,页面可以缩放,也可以一键隐藏按钮,纯看原图。
跟读评分不是简单地说“对 / 错”。它会把目标句和识别结果做归一化,处理缩写(didn't → did not)、英式 / 美式异体(colour / color、mum / mom),再按准确度、完整度、流利度三个维度打分,并标出哪个词没读出来。同一句反复练,只保留最高分。算法细节放在后面的技术篇。
课课练听力把 40 段录音的录音稿按“大题标题 / 编号小题 / 整段短文”三种块组织起来,A:、B: 这样的行内说话人会渲染成小标签。孩子听一遍,再对着稿子核对,比只看答案更接近真实使用。
单词总表除了发音,还有一个很实用的小交互:鼠标在单词上停 2 秒,浮出它的动词或名词词形变化;行尾的“+”直接把它加进生词本。课本里的词和语法模块用的是同一份词形数据,所以看到的过去式、过去分词、三单、现在分词、复数不会互相打架。
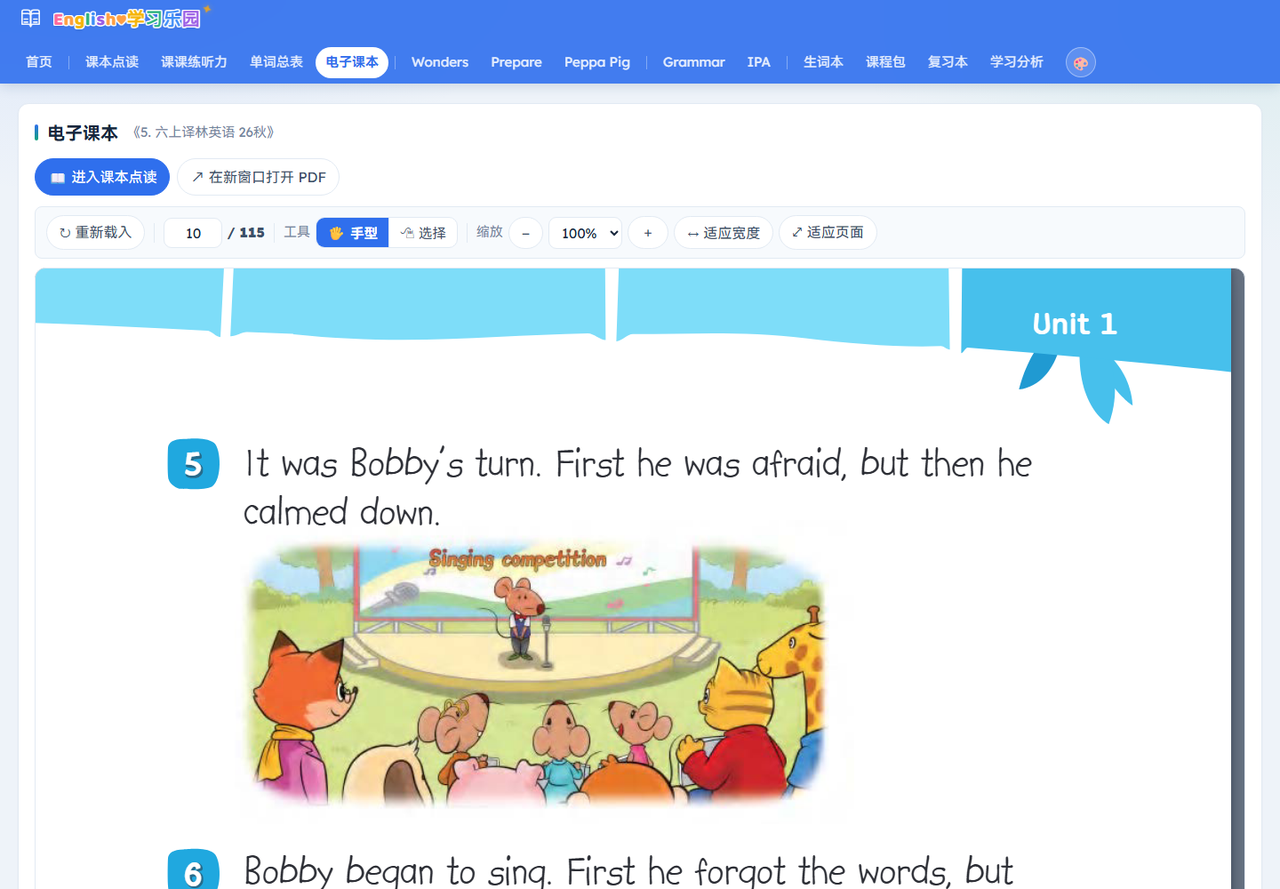
电子课本:不用浏览器自带的 PDF 查看器,自己渲染页面,才有“手型工具”。
电子课本是自建的 pdf.js 阅读器。之所以不用浏览器自带的 PDF 查看器,是因为它跑在扩展的跨域文档里,既改不了 UI,也注入不进去,更没有“手型工具”。自建之后,缩放(50%–300%)、连续滚动、拖动平移、页码跳转都说了算;一本 23MB、115 页的课本,也能边滑边渲,不用一次全塞进内存。内存具体怎么省的,放在技术篇。
2. 课外学习:Wonders、Prepare、Peppa Pig
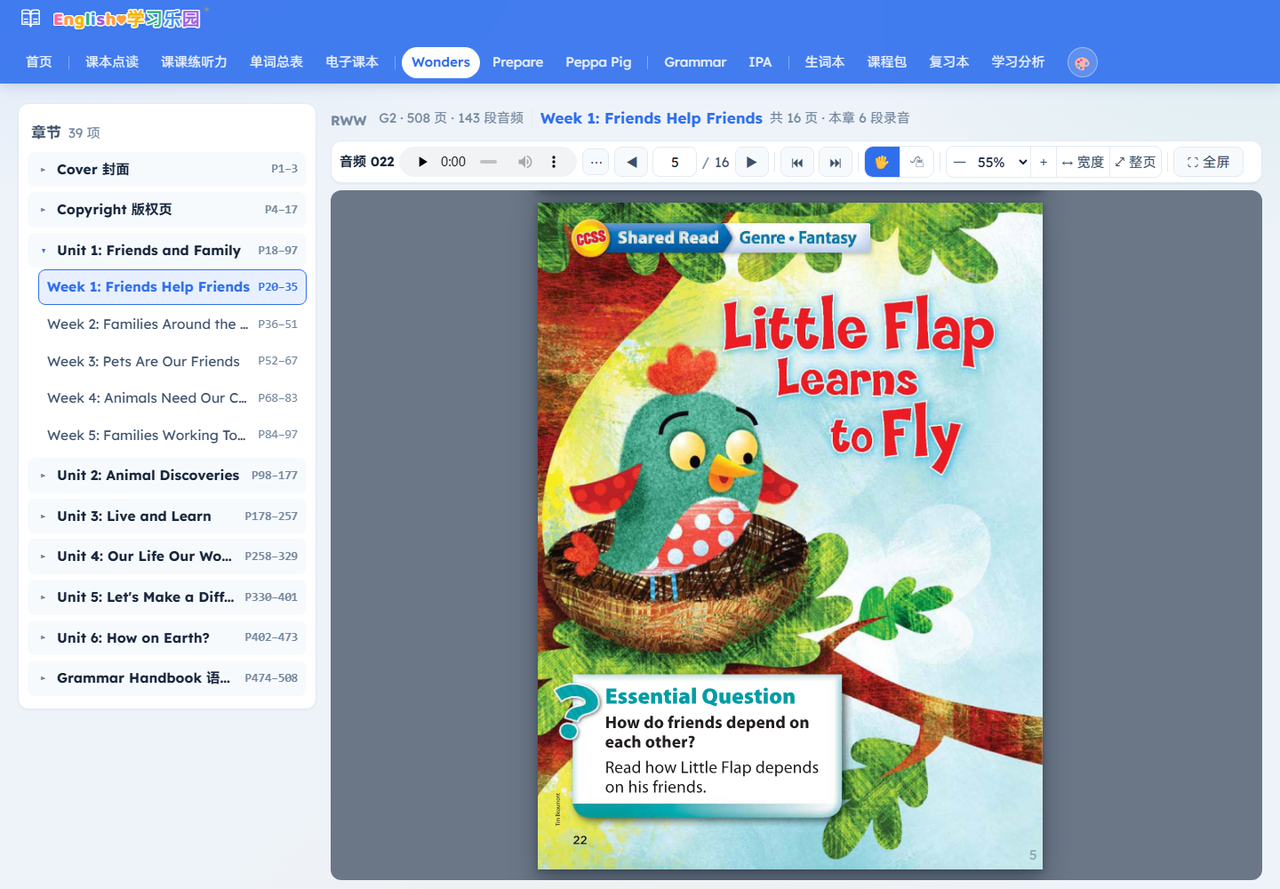
Wonders:左侧章节,顶部音频和页码,右侧原版页面;读到哪里,音频就跟到哪里。
Wonders G2 有三块:Reading/Writing Workshop(508 页、143 段音频)、Literature Anthology(602 页、542 段音频)、Leveled Readers(4 个难度 × 30 本,每本 23 页、19 段音频)。三本书共用同一套“连续页面”阅读器,左右翻页、缩放、页码、音频跟随都是同一套逻辑。
Leveled Readers 有文字层,可以直接划选单词加进生词本;两本大书的源 PDF 抽不出文字层,界面对这个情况直说,并给出“手动输入”的入口。这种“承认限制”的处理,比假装功能完整更重要。
Prepare Level 4 是三块:Student’s Book 音频 100 段(61 段有录音稿,39 段是录音稿未收录的“额外轨”)、Workbook 音频 11 段、13 段视频。录音稿可以开关,音频按 Unit 分组,目录里没收录的轨也不丢,只是标成“录音稿未收录”。
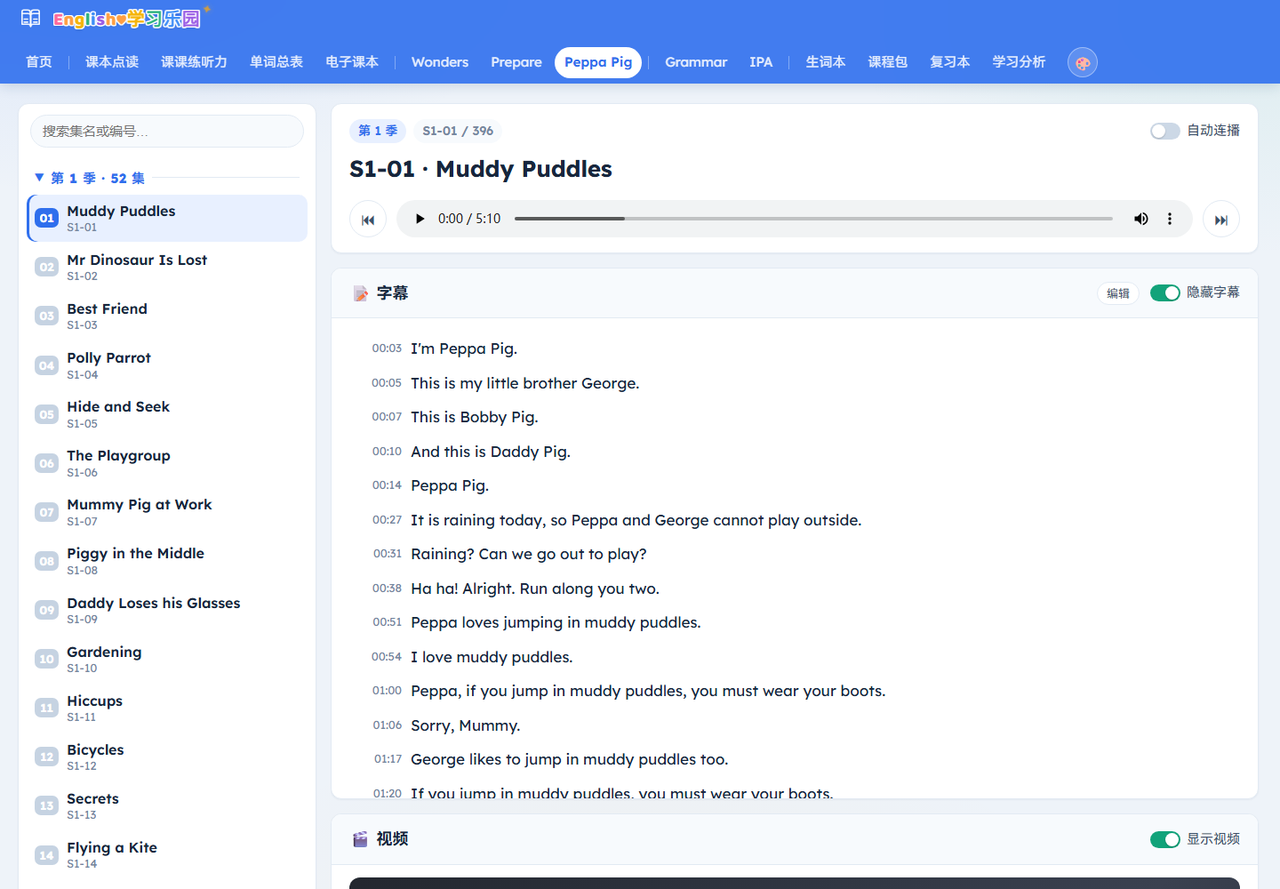
Peppa Pig:左边选剧集,右边播放器 + 逐句字幕;点一句就跳到那句。
Peppa Pig 是 8 季、396 段音频的播放器,左侧目录可折叠、可搜索,右侧是播放器 + .lrc 同步字幕:逐句高亮、点句跳转、自动跟随。字幕只有第 1 季 52 集有,这是正常状态,不是加载失败;没有字幕的集就好好显示“没有字幕”。
3. 学习工具:Grammar 与 IPA
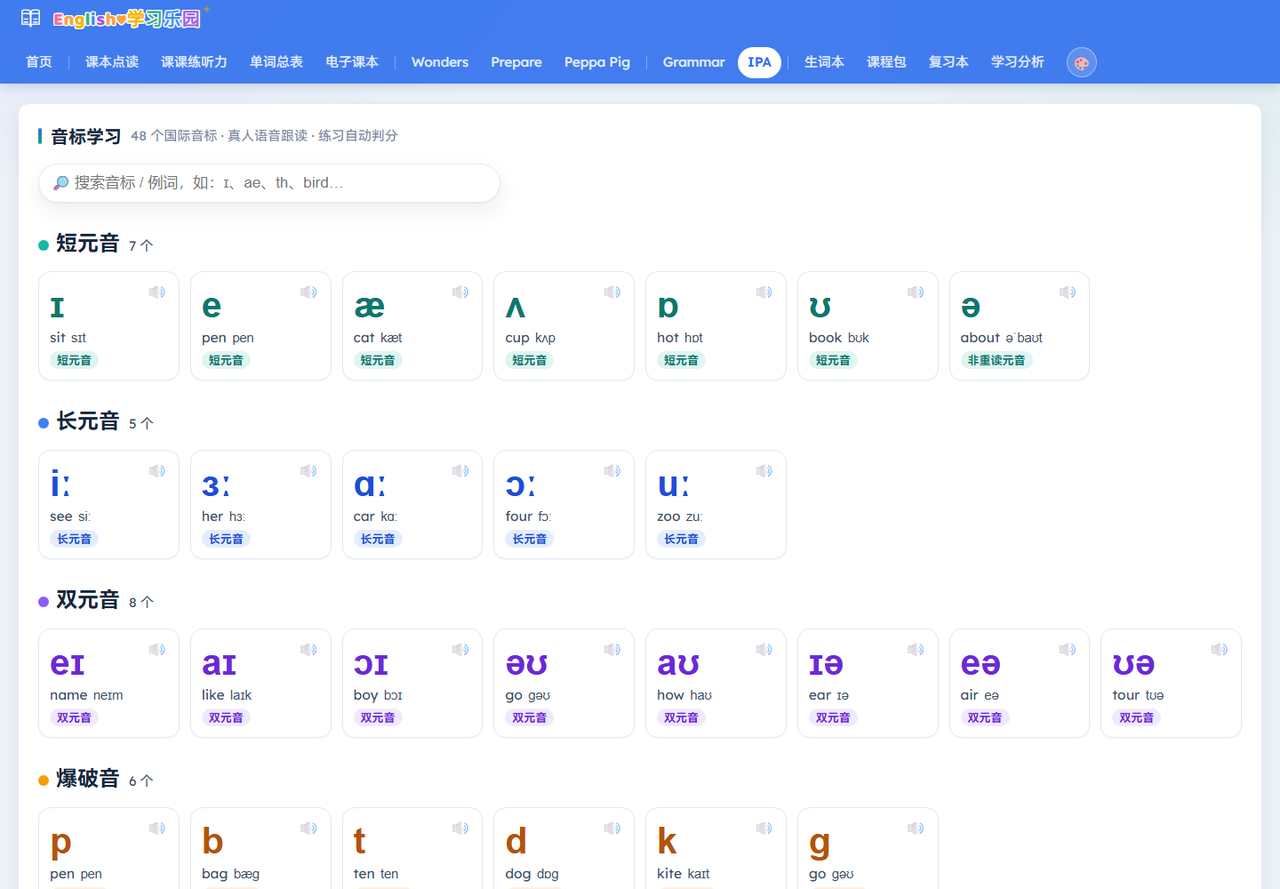
IPA:48 个音标按短元音 / 长元音 / 双元音 / 辅音分组,每个音标都有发音和例词。
IPA 是 48 个国际音标(英式 DJ 体系:20 个元音 + 28 个辅音)的独立学习页:总表、每个音标的详情(发音要领、例词、字母组合、易混音)、自动判分练习。音素音 48 个、例词音 325 个,例词是英音真人录音。详情页会把“容易混的那个音”单独拎出来对比,比如 /ɪ/ 和 /iː/,这比只给一个音标符号有用。
Grammar 不是一张静态的表,而是“规则 + 例词 + 不规则分组”的结构:过去式、过去分词、第三人称单数、现在分词、名词复数五类,每一类下面既有规则条目,也有不规则变化的分组。支持按词形 / 中文搜索、只看课本单词、按变化规则分组,也可以录入自己的词。录入新词时,词形变化优先从有道词典取,取不到才回落到本地规则引擎——规则引擎会把 write 推成 writed、把 deer 推成 deers,这类只能靠词库。
4. 学习闭环:生词本 → 课程包 → 练习 → 复习 → 分析
这是整个网站最花心思的部分,也是从“看过”到“记住”的关键。
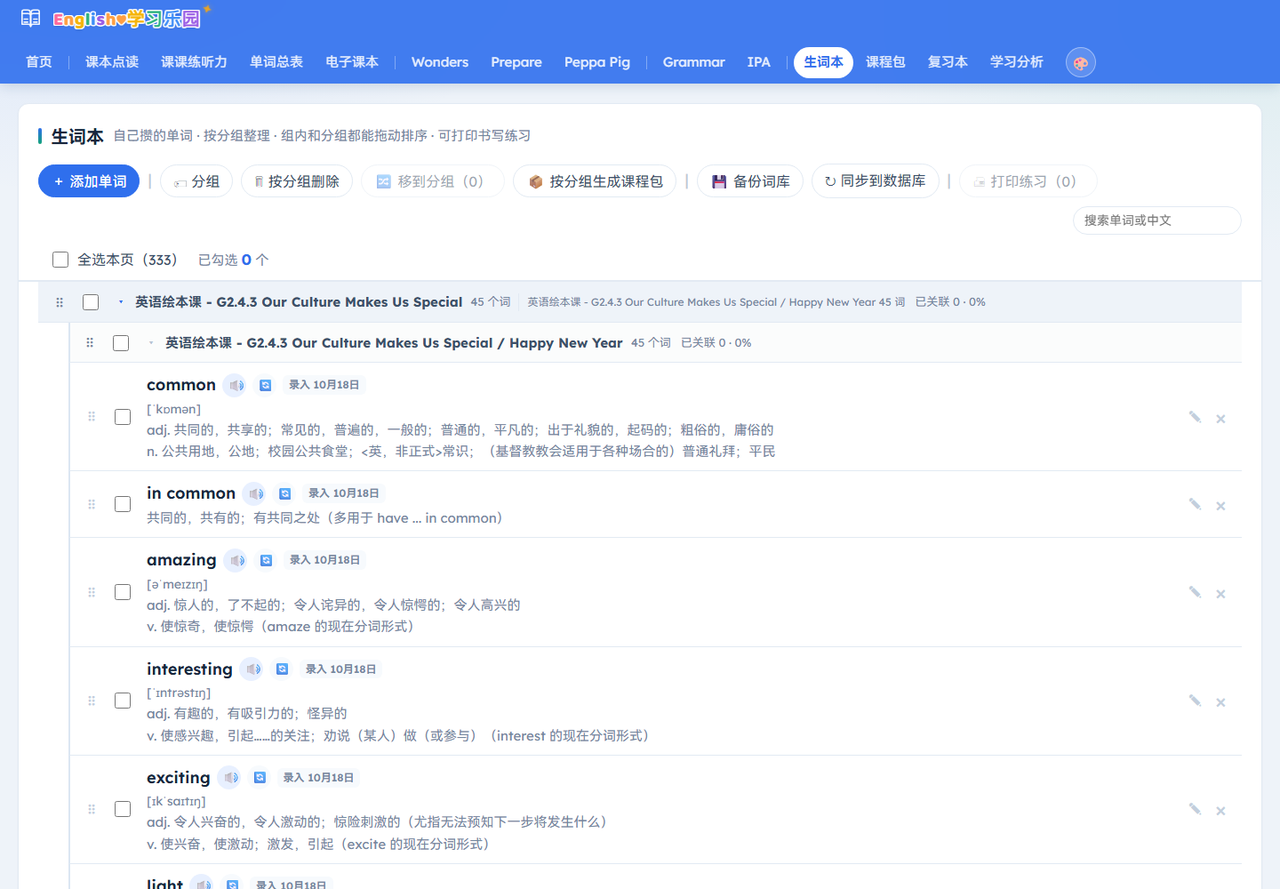
生词本:按来源分组,词条带音标、释义、发音、录入时间,组内和分组都能拖动排序。
生词本是一个纯词库管理器,不做复习调度。分组按“来源”而不是按录入时间:每个词带着自己的来源,组顺序就是来源清单的顺序;“未分组单词”是一个真实存在的组,永远排在最后。同一个词可以既在“课本 Unit 1”又在“课外阅读”里,但在同一个来源里只能有一条。
它支持增删改、搜索、批量移动分组、按分组删除、导入导出、备份,以及 A4 四线三格的书写练习打印。拖动只改顺序,不碰录入时间;组内拖动只在同组内生效,跨组拖不给;分组头可以拖动排序。这些细节看起来琐碎,但每天用的时候,顺不顺手就差在这里。
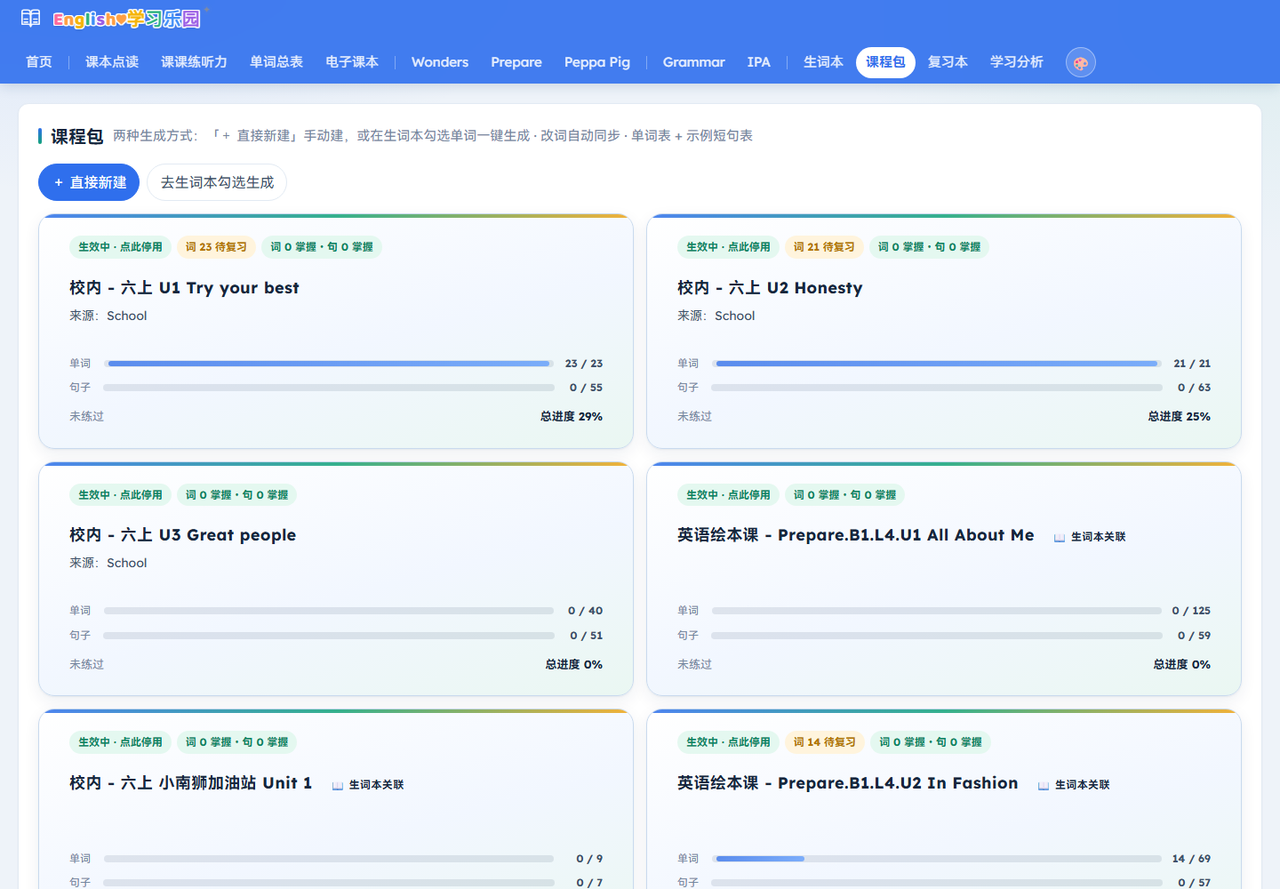
课程包:每张卡片显示词/句进度、待复习、掌握情况;词句都练过才算“总进度”上去。
课程包是“正式学习”的单位。在生词本里勾选若干单词,一键生成课程包;课程包的单词表就是勾选的词,句子表是这些词的示例短句。生词本里对单词的修改会自动同步到引用它的课程包:改释义、音标、例句会跟着更新,删词会一并移除,改名或换组则把旧词条从课程包移除——宁可少一个词条,也不把两条词并成一条。
课程包还支持子课程包、手动新建、启用 / 停用、拖动排序和打印练习。每张卡片上都能看到“词 / 句”的完成进度、待复习数、已掌握数,点进去就是详情和练习入口。
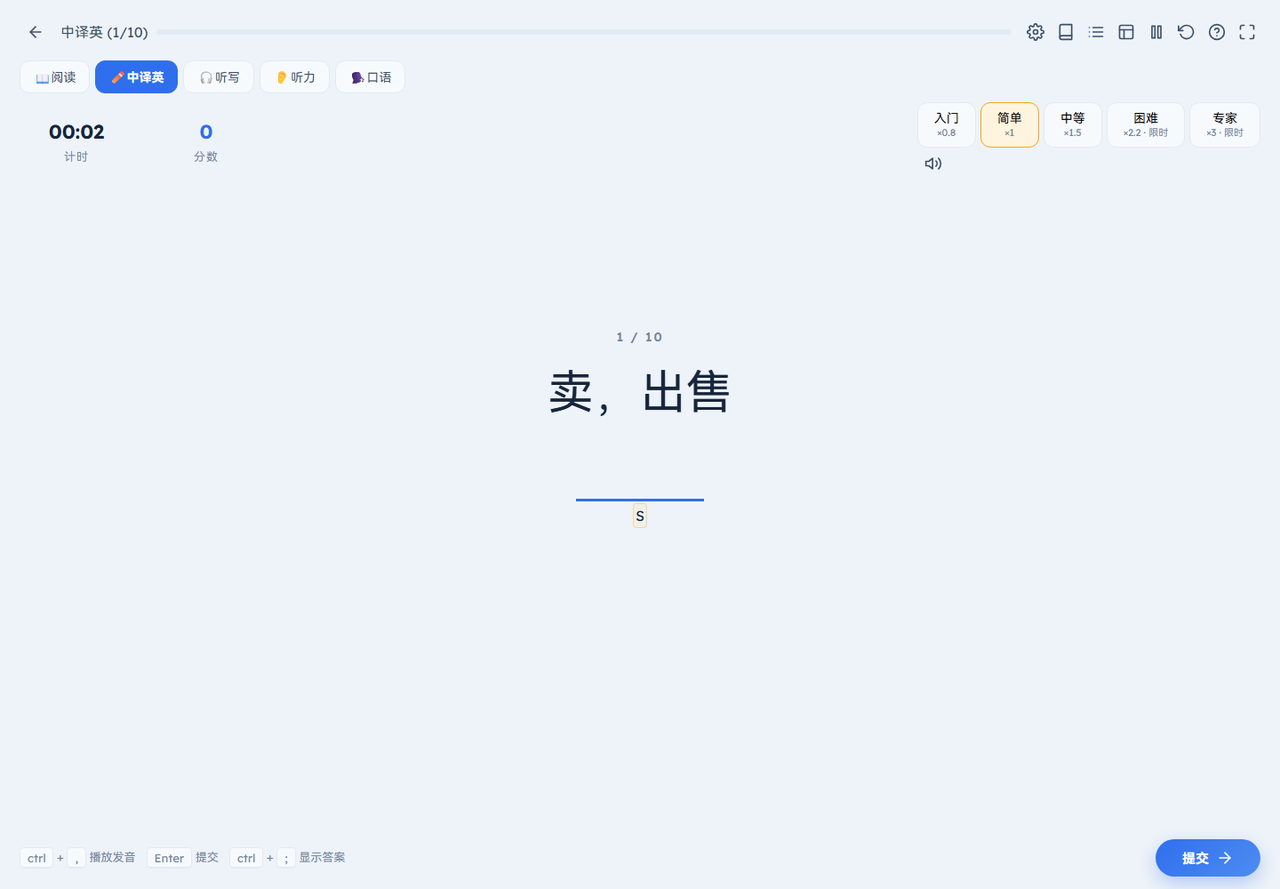
练习台:中译英、首字母提示、计时、5 档难度;答完一题立刻给对错和得分。
练习引擎有 5 种模式:阅读、中译英、听写、听力、口语;5 档难度:入门、简单、中等、困难、专家,分别对应不同的提示、限时和得分倍率。题量可以是全部、5、9、12、15;支持单词练习、句子练习、子课程包练习、单题练习。答题后统一写回复习调度字段,并追加一条复习日志。
阅读是“通读 + 点词”,不计分;中译英看中文打英文;听写听发音写句子;听力是“盲听 → 慢听 → 字幕”三遍;口语是跟读录音,按分数判定掌握程度。练习台里有计时、连击、音效和结算页,孩子做起来更像在闯关,而不是在做卷子。
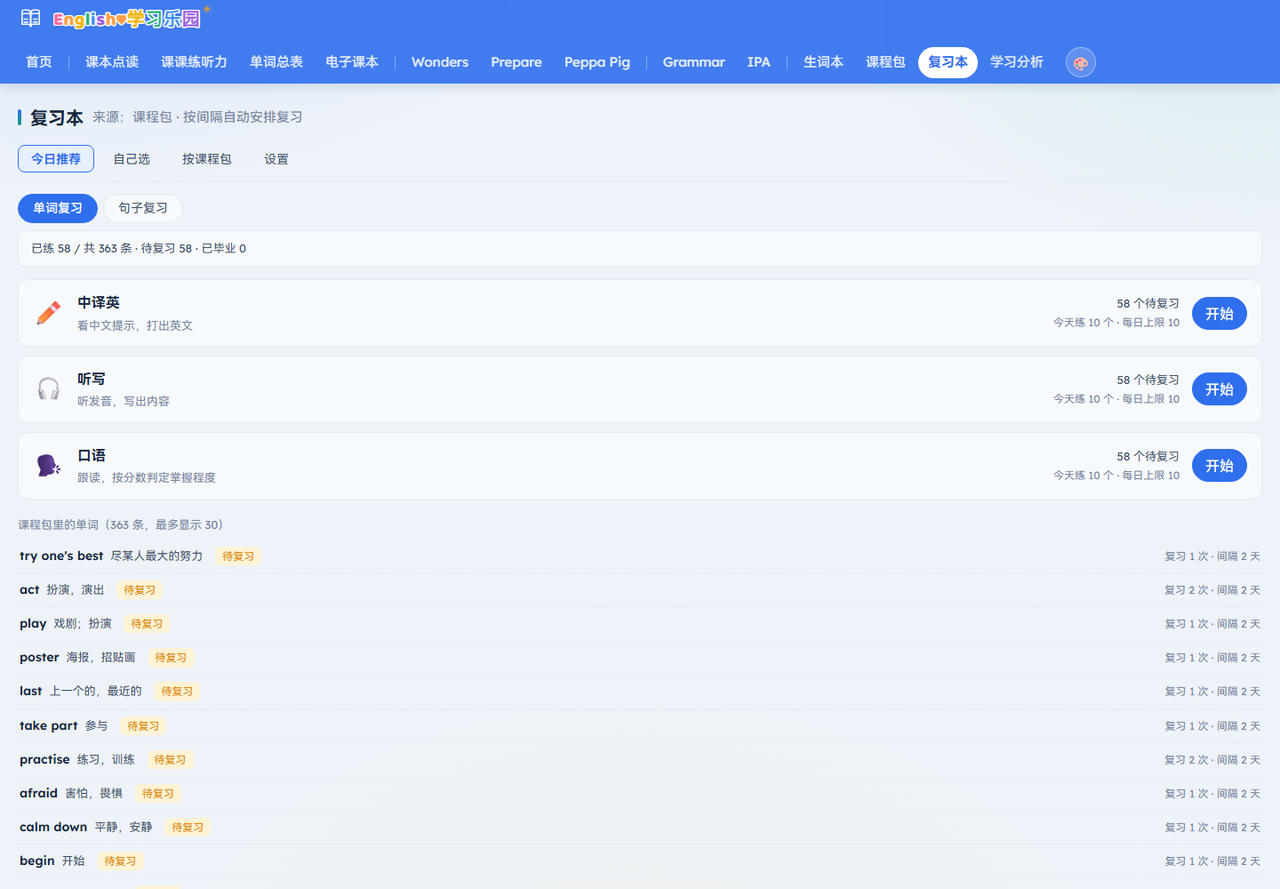
复习本:按“今天该练什么”推荐,每个模式默认 10 个;也可以自己选、按课程包看。
复习本是调度器 + 启动器。条目来源是课程包里所有单词和句子,按归一化英文跨包去重合并;同一个英文内容出现在多个课程包,只算一条,练习结果写回它的所有副本。间隔算法按每次练习的质量 q ∈ 0..3 调整:
q = 3   一次答对、没修改、没看提示     间隔 × 2.4
q = 2   答对但看了提示 / 口语 60~89    间隔 × 1.6
q = 1   第一次答错 / 口语 < 60         间隔 ÷ 3
q = 0   跳过 / 直接看答案              间隔归 1

上限 365 天;间隔 ≥ 180 天算“毕业”,不再推荐;
答错导致间隔缩短时,自动“复活”。
每天每个已开启的复习模式默认推荐 10 个,也可以按模式自定义数量,或者切“仅错题”“手动选择”。按课程包视图还能批量删除复习记录。复习本不重复造练习界面,中译英、听写、听力、口语的真实输入、录音与评分都交给练习引擎。
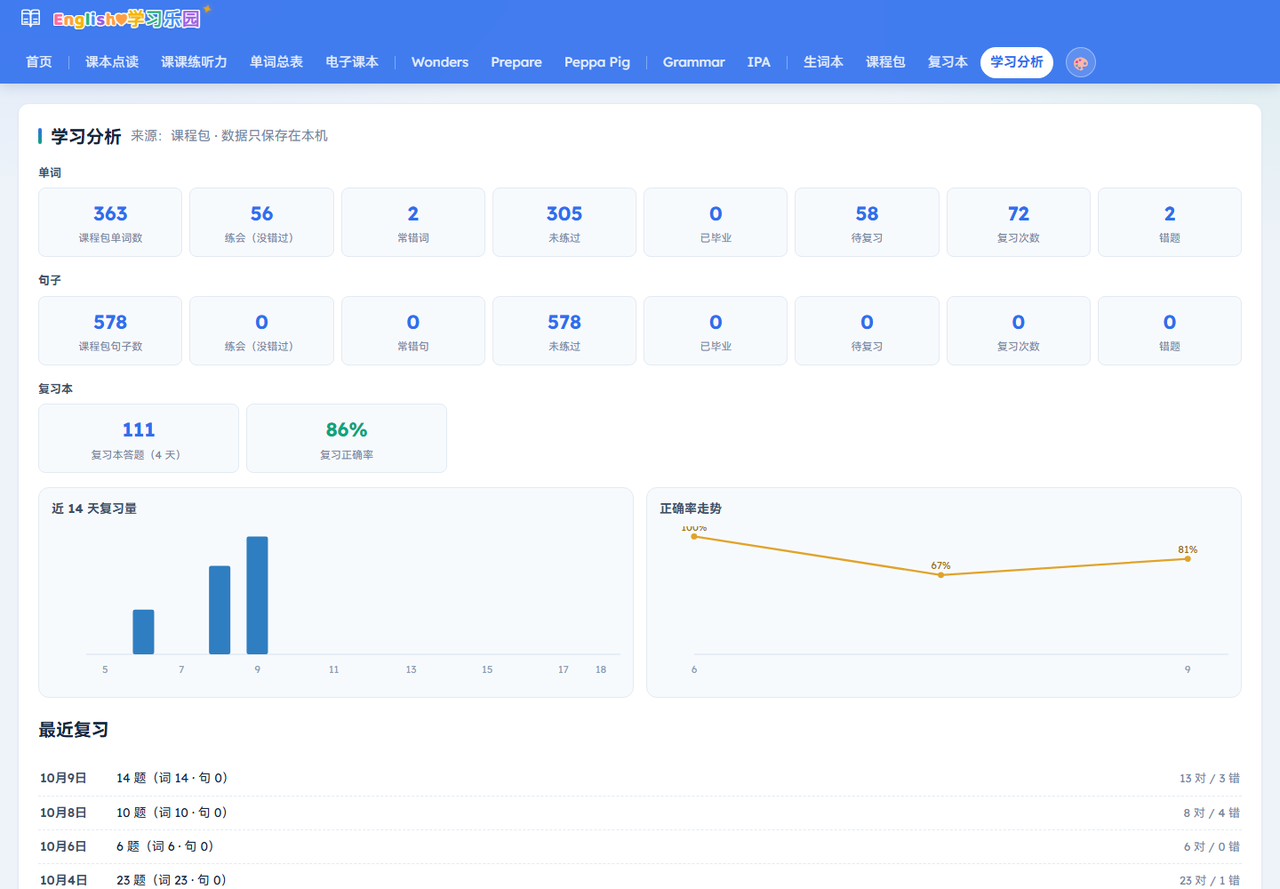
学习分析:单词 / 句子 / 复习本三组统计,近 14 天复习量与正确率走势,以及最近复习记录。
学习分析直接复用复习本的 stats() 口径,保证“卡片说练了多少”和“复习本推荐什么”永远是同一个算法算出来的。近 14 天正确率图是手绘 SVG,没有为了两张图引入 ECharts。清除学习记录只清复习调度、日志和配置,不删课程包里的单词和句子——学习内容和学习记录是两回事。
5. 一些使用细节
- 5 套主题:A 纯净留白、B 柔和彩卡、C 活力深顶、D 双色克制、E 智感极简,选择存在数据库里,下次打开保持一致。
- 打印:生词本和课程包都能打印 A4 四线三格书写练习,打印顺序 = 显示顺序,拖动改完两边一致。
- 年级:课堂学习 / 课外学习各自一个下拉,加一个年级只要放好资源目录、在注册表里加一条,
index.html不用动。 - 本地优先:字体、pdf.js、音效全部本地自托管,不请求外部 CDN;只有查词和 Stanza 成分分析会走本地代理,失败也能降级。
- 报错上报:浏览器里的 JS 报错 / 资源 404 会推给本地服务,一行一条打进控制台窗口,专门抓“界面看起来没事、其实资源没加载”的问题。
三、技术实现
功能讲完,下面是幕后。这一节不展开每个模块,只讲几个影响最大的决定。
1. 整体架构
浏览器(原生 HTML / CSS / JS,无框架、无打包器)
  ├─ index.html + assets/*.js
  ├─ 内存 KV(唯一副本,开机从 DB 同步拉回)
  └─ 600ms 防抖 → POST /api/save
        │
        ▼
本地服务 serve.py
  ├─ 静态文件 + HTTP Range(视频拖进度条)
  ├─ /api/save:一个 SQLite 事务写课程包 + 站点键
  ├─ /api/dict:有道词典代理(浏览器直连没有 CORS)
  └─ 自动拉起 wordarena_bridge.py(Stanza 成分分析)
        │
        ▼
SQLite wordarena.db
  └─ app_data(key, value, updated_at)  — 只有一张表
2. 数据层:SQLite 是唯一真相
早期版本采用“浏览器 localStorage 是真相,服务端只是镜像”的模式,而且只在“本地这个键压根不存在”时才从数据库拉。结果就是同一个键在两边各有一份,谁新谁旧没人管。表现就是“改完刷新又变回旧数据”,但界面上没有任何报错。
后来彻底反过来:wordarena.db 是唯一真相。页面启动时同步把全量数据拉回内存 KV;业务模块在脚本求值期直接读;任何改动由 KV.setItem() 标记脏键,600ms 防抖后 POST /api/save,服务端用一个 SQLite 事务写课程包和站点键。跨标签页同步从 storage 事件换成 BroadcastChannel。浏览器正常运行时一处 localStorage 都不许有,连主题、年级、朗读语速、练习音效这些设备偏好也全部进了数据库。
数据库只有一张表:
app_data(
  key        TEXT PRIMARY KEY,   -- 人可读的键名:vocabulary / course_packs / review_log ...
  value      TEXT NOT NULL,
  updated_at TEXT NOT NULL
)
前端仍然用 yl6a-vocab-v1 这类内存键名,映射在服务端的 STORE_KEY_MAP 里。跨语言字段契约单独放在 dev/fixtures/db-fields.json:JS 的 dbShape() / importFromDb() 和 Python 的 _merge_db_pack() 都读它。加字段时两边一起改,否则测试会红。
3. 内容管线:不手写数据,写生成器
Wonders 的源目录有 4700 多个文件,Peppa 有 396 段音频,IPA 有 48 个音标和 325 个例词,课课练有 40 段录音稿。这些数据如果手抄,必错;而且“书架里有这本书、音频里没有”这类不一致,只有构建期才查得出来。
所以能自动化的内容尽量走生成器:genwonders.js、genipa.js、genpeppa.js、genkkl.js、gengrammar.js。Wonders / IPA / Peppa 的生成器都带 --check 模式,只校验产物是否过期,不写文件;课课练和语法则由 kklcheck.js、grammarcheck.js 从产物侧比对。Peppa 的产物里还带一个目录清单的 sha1,--check 和测试都拿它跟真实目录对账,防止“加了新一集、产物忘了重生成”这种静默漂移。
Wonders 的页号映射是最典型的一次“先验证、再写死”:音频文件名里的编号 = PDF 的页标签,物理页 = 页标签 + 2。这个规则是用 PyMuPDF 读过三份文件的 get_page_labels()、逐页核对过的,不是猜的。之前按“第几个音频”数顺序,结果第 22 段被标成第 1 页,全错。Peppa 的 .lrc 也一样:源文件时间戳是 Whisper 分段顺序,渲染前必须按时间排序,否则逐句高亮会乱跳。
4. 两个前端细节:阅读器内存与发音评分
阅读器内存:电子课本 23MB / 115 页。按 1240px 宽、dpr 2 渲染,一页 canvas 就是 34MB;所以只保留“视口内 ±1 页”的位图,单页像素总数封顶 500 万,滑远了把 canvas 的宽高置零,滑回来再渲。Wonders 复用同一套连续页面模型,只是页面来源从单本 PDF 换成三本书。
发音评分:走浏览器 Web Speech API。目标句和识别结果先归一化(缩写展开、英 / 美异体合并、标点转空格),再用编辑距离做词级对齐,把每个词标成命中、近似、替换、漏读、多读。总分 = 50% 准确度 + 35% 完整度 + 15% 流利度;有识别置信度时按 85 / 15 混入。近似词按 0.7 计,流利度参考 110 词/分钟。
5. 没有打包器,也要有加载秩序
这个站点没有 Webpack、Vite、Rollup,也没有 TypeScript。好处是改完刷新就见效,坏处是所有加载顺序、全局变量、依赖关系都得自己管。
课本和 Wonders 的年级脚本是按注册表在解析期同步注入的:
var files = Grades.scripts('klass');
for (var i = 0; i < files.length; i++) {
  document.write('<script src="' + files[i] + '"><\/script>');
}
必须用 document.write,因为普通动态 <script> 是异步的,会让 app.js 先跑,那时 window.SITE_DATA 还没影,整站白屏。代价是这段代码只能在解析期跑,不能挪进 DOMContentLoaded,否则会把整页冲掉。同样的约束也出现在 pdf.js 上:锁死 UMD 版 3.11.174,因为 4.x / 5.x 只发 ESM,而本站没有打包器,用不了。加一个年级,只需要在 assets/grades.js 注册表里加一条、放好资源目录,index.html 一行都不用改。
6. 测试与护栏
项目里有 39 项自动化检查:22 个 jsdom 检查、3 个 Python 测试、14 个真实 Chrome 探针。npm test 会把站点拷到一个临时目录,用私有数据库副本另起一个服务,跑完连目录一起删。
这不是“为了覆盖率好看”。它来自两次真实事故:一次是浏览器探针直接打在 8000 端口的 live 站点上,把课程包整组替换、词库冲掉;一次是收尾时执行了 git checkout -- wordarena.db,把当天中午新增的 44 个生词连同分组改名一起还原掉,界面上没有任何报错。
围绕数据库回滚,项目现在有三道闸:dbguard.py 比对工作区、HEAD 和基准文件,条目变少就红;.git/hooks/pre-commit 在提交时直接拒绝“库比 HEAD 少数据”;autocommit.js 在提交前跑测试、扫密钥、checkpoint 数据库,再跑一遍上面的检查。还有一条更隐蔽的教训:“跳过”不能算“通过”。临时实例起不来时,14 个浏览器探针会全部 ok: null;旧逻辑只看失败数,于是“一个探针都没跑”也能 exit 0。现在默认把跳过算失败,确实要降级必须显式 ALLOW_SKIP=1。
四、AI 编程在其中的作用
如果只看结果,很容易以为这是“让 AI 写一个网站”。实际过程更像:
人负责方向和验收,AI 负责把方向落成代码、测试和文档。
| 阶段 | AI 主要做什么 | 人主要做什么 |
|---|---|---|
| 需求拆解 | 把“我要一个点读页”拆成页面、音频、句子、评分、数据落库 | 决定做什么、不做什么,判断对孩子是否真的有用 |
| 编码实现 | 跨模块写代码、补边界、保持命名和加载顺序一致 | 定架构、审关键路径、跑起来看效果 |
| 内容工程 | 写生成器、解析 PDF / 音频 / 字幕、做 OCR 与匹配 | 抽查内容、核对教材、决定“这条算不算错” |
| 调试排障 | 读日志、复现、定位、给出修复 | 提供真实现场、判断风险、拍板取舍 |
| 测试护栏 | 写 jsdom / Python / 浏览器探针,补回归 | 决定哪些行为不能坏、事故后复盘 |
| 文档沉淀 | 写 AGENTS.md、模块头注释、迁移说明 |
确认约定仍然成立,删掉过时的部分 |
1. 真正稀缺的不是“写代码”,是“跨文件的一致性”
这个站点有 29 个 JS 文件、约 2.9 万行(含生成的数据文件),一个约 2000 行的 serve.py,还有 dev/ 下约 2.8 万行的测试与工具。模块之间的隐性约定非常多:
- 资源路径要逐段
encodeURIComponent,不能整条编码,否则/会被编掉; - 日期都按本地日期算,绝不能用
toISOString(),否则晚上八点之后会算成第二天; - 课程包的“推上去的形状”必须能“拉下来还原”,
dbShape()和importFromDb()是一对; - 新增字段必须同时改 JS 和 Python,否则
db-fields.json的契约测试会红; - 导航顺序和项数被测试断言,改导航要同步改
route()、data-nav和两个测试。
这些约定单看都很小,但一个 2.9 万行的项目里,漏掉任何一条都会变成“界面上看不出来、数据却错了”的 bug。AI 在这里的价值,不是一次写出多少行,而是记得住这些约定,并且在改 A 的时候顺手检查 B。
2. 把口头约定变成可执行的检查
项目里有一份 AGENTS.md,本质上是一份“给 AI 的项目宪法”:怎么启动、怎么跑测试、数据库为什么不能回滚、探针为什么必须跑临时实例、生成产物为什么不能手改、加年级要改哪几个地方。
这份文档不是为了“给 AI 看”而写的,它是被事故逼出来的。每一次踩坑,最后都沉淀成一条可执行的规则,或者一条测试断言。比如浏览器探针必须设 SITE_PORT=8001-8030,撞 8000 直接拒绝;测试里 Python 子进程必须强制 UTF-8,否则中文 Windows 的 cp936 会让 ✓ / ✗ 直接 UnicodeEncodeError;wordarena.db 入库只为了“整库随仓库走”,它不是回滚点。
AI 编程最值钱的地方,或许不是“生成”,而是让“每次提交都跑一遍 39 个检查”这件事变得不费劲。人很难长期坚持这种纪律,AI 可以。
3. 内容工程:AI 不只是写代码
项目目录里还留着两类很能说明问题的 AI 协作痕迹。
一类是 AI IDE 留下的实施计划,例如 .trae/documents/aurora-glass-polish.md。它不是“帮我改一下 CSS”,而是一份完整的方案:极光底色、毛玻璃顶栏、主题色块、hover 体系、微动效,逐项写清楚;最后还有一节“明确不做”——不改 theme.js、不改 index.html、不动功能模块内部样式、不额外增加主题。先约束范围,再动手,这比生成多少 CSS 更重要。
另一类是任务记忆,例如 .workbuddy-ai/memory/2026-10-14.md。它记录了一次教材配图转例句的过程:33 个词里 28 个匹配成功、写入 42 条例句,5 个词没有对应句子;还记下了两个匹配器的边界——The Rolling Stones 里的 Rolling 被误还原成 roll,引号包裹的 'youth culture' 被正则吃成 culture'。这些不是“代码”,却是内容工程里最费时间、最容易出错的部分。
4. 复盘:把事故变成护栏
这个项目里最典型的 AI 协作,不是“写一个功能”,而是“事故之后的系统性修复”。
数据库被探针冲掉之后,做法不是“下次小心点”,而是:探针改跑临时实例、liveguard 拒绝写 8000、runtests 把跳过算失败、autocommit 提交前 checkpoint + 比对基准。数据库被 git checkout 还原之后,做法不是“记住别这么干”,而是:dbguard 回滚探测器、pre-commit hook、autocommit 第三道检查。这些护栏本身也是代码,也有测试(dbguardcheck.py、liveguardcheck.py)。AI 很适合做这种“把一次教训固化成一条永远生效的规则”的工作,因为它不嫌烦。
5. 边界:AI 不能替人做的四件事
也得把话说清楚。这个项目里,AI 不能替人做的大概有四类:
- 产品判断:要不要做“学习分析”?复习本要不要按课程包组织?这些不是技术问题,是“孩子到底怎么学”的问题。
- 审美与体验:5 套主题、卡片密度、动效节奏,最终都要人看一眼,觉得“舒服”才算数。
- 数据安全:哪些数据可以进仓库、哪些操作绝对不能做、出了事怎么恢复,必须由人拍板。AI 可以执行规则,但不能替人承担后果。
- 真实世界的验收:麦克风在真实环境里能不能用、音频对齐不准、某个词孩子就是读不对——这些只有人戴上耳机、点一遍才知道。
AI 生成的代码比例,我没有精确统计,也不觉得重要。重要的是:它把“一个人做一个完整产品”的门槛,从“会不会写”降到了“知不知道为什么写”。
五、代价与没做好的地方
这篇文章如果只讲成功,就不可信了。这个项目有不少明显的代价:
第一,数据层返工很痛。 从 localStorage 到“数据库唯一真相”,中间经历了迁移、设备偏好入库、迁移标记必须进库、开机零写入等一系列问题。最隐蔽的一个是:迁移标记如果只存在内存里,每次开机都会重跑一次迁移,于是每次开机都判脏、都 POST 一次,写进去的内容和库里一模一样。这类 bug 不会让界面变红,只会让数据库悄悄被覆盖。
第二,live 数据太容易被测试碰到。 浏览器探针会真写数据,早期默认打 8000 端口,后果是真实的词库被冲掉。现在虽然有了临时实例和端口护栏,但“测试”和“真实数据”之间的边界,仍然是这个项目里最需要小心的地方。
第三,没有打包器的代价。 全局变量、脚本顺序、document.write、UMD 版本锁定,都是真实的维护成本。加一个模块,要同时想清楚它在哪个脚本之后加载、会不会和别的模块抢 document 上的事件委托。项目用“约定 + 测试”扛住了,但这不代表它适合所有人。
第四,内容仍有缺口。 Peppa 只有第 1 季有字幕;Wonders 两本大书的文字层是空的;部分音频与页面的映射仍保留 provisional 标记,需要人工核对。前两项在界面上如实说明,没有假装完整。
第五,它只适合本机。 没有多设备同步,没有账号,没有协作;数据库文件在仓库里,但那是为了“整库随仓库走”,不是备份策略。真要备份,还是得单独拷一份。
六、一些数字
| 维度 | 数字 |
|---|---|
| 课内教材 | 8 个单元、40 个板块、159 个单词、285 个句子、17 段视频、115 页 PDF |
| 课课练 | 40 段听力录音稿 |
| Wonders | 508 + 602 页、143 + 542 段音频、120 本分级读物(4 难度 × 30 本) |
| Prepare | 100 段 SB 音频、11 段 WB 音频、13 段视频 |
| Peppa Pig | 8 季、396 段音频(第 1 季 52 集有字幕) |
| IPA | 48 个音标、325 个例词音频 |
| 代码 | 29 个 JS 文件约 2.9 万行;serve.py 约 2000 行;dev/ 约 2.8 万行(测试、生成器与排查脚本) |
| 工程 | 39 项自动化检查;24 次提交;5 套主题;14 个导航入口 |
七、写在最后
这个网站不完美。它的代码里有大量“当时只能这么办”的妥协,有些模块的注释比代码还长,有些边界仍然靠人盯着。
但它已经在一个真实的孩子身上跑起来了:点读、跟读、听写、复习、看正确率。它解决的不是“有没有一个网站”,而是“每天愿不愿意打开它”。
如果问我 AI 编程在这个项目里最大的作用,我会说:它让一个人也能维护一个足够复杂的系统——不是因为它不会犯错,而是因为犯错之后,可以把错误变成测试、变成护栏、变成文档,然后继续往前走。
接下来想做的,不是加更多功能,而是把已有的内容补齐、把边界写清楚。毕竟,给孩子用的东西,可靠比功能多更重要。